티스토리 뷰
1. 멀티 코어 기반의 처리량 극대화를 위한 Fork/Join 프레임워크
[ 하드웨어의 발전과 기존 방식의 한계 ]
Fork/Join 프레임워크를 이해하려면 하드웨어의 발전에 대해서도 이해할 필요가 있다. 초기의 하드웨어는 1개의 CPU 안에 1개의 코어만 담겨있는 단일 코어 구조였다. 따라서 해당 코어의 처리 성능을 높이는 사실상 유일한 방법은 클럭 속도를 올리는 것이었다.
하지만 2000년대 단일 코어 클럭 속도 상승이 전력과 발열 한계에 부딪히면서 CPU 제조사들은 클럭 대신 코어 수를 늘리는 방향으로 선회했다. 이제는 여러 개의 코어를 활용할 수 있게 되었고, 멀티 코어 환경에서 컴퓨팅 리소스를 잘 활용하기 위한 도구들이 필요해졌다.
2004년, ThreadPoolExecutor와 Executors 같은 자바의 동시성 도구들이 Java 5에 들어올 당시에는 "많은 독립적인 요청을 여러 스레드가 나눠 처리한다"는 전제로 설계됐다. 하지만 이제는 코어를 최대로 활용할 수 있게, 1개의 큰 계산을 서로 다른 코어에서 나누어 처리해야 할 필요가 생겼다. 위와 같은 문제를 해결하기 위해, Java 7에 Fork/Join 프레임워크가 등장하게 됐다.
[ Fork/Join 프레임워크 ]
ForkJoinPool
Fork/Join 프레임워크는 1개의 큰 작업을 재귀적인 작은 작업으로 분할하여 여러 코어가 나누어 처리하고, 각각의 서브태스크 작업 결과를 합쳐서 전체 결과를 만들도록 설계되었다. Fork/Join 프레임워크는 이를 위해 서브태스크를 스레드 풀의 워커 스레드에 분산 할당시키는 ForkJoinPool을 제공한다. 해당 클래스는 스레드 풀을 활용해 작업 실행과 관리를 하는 ExecutorService 인터페이스를 구현한다.
즉, Fork/Join 프레임워크는 ForkJoinPool을 활용해 사용자에게 보이지 않는 스레드 풀에서 작업을 자동으로 스케줄링하는 것이다. ForkJoinPool은 Thread보다 "작은" 동시성 단위인 ForkJoinTask를 처리한다.
ForkJoinTask
우리는 보통 "동시에 실행되는 일 = 스레드"라고 생각한다. 100개를 동시에 처리하려면 스레드 100개가 필요하다고 여기는 것이다. 하지만 자바의 스레드는 무겁다. java.lang.Thread(플랫폼 스레드)는 OS 커널 스레드와 1:1로 매핑된다. 임의의 시점에 블로킹할 수 있고, 인터럽트를 받을 수 있고, 우선순위를 가지며, 각자 스택을 갖고 OS 스케줄러의 관리를 받는다. 따라서 자바 스레드는 무겁고, 플랫폼에 따라 객체당 1~2MB가 요구되고, 생성과 컨텍스트 스위치마다 커널이 개입한다. 수십 개라면 문제없지만, 분할정복처럼 작업을 수만 개로 쪼개는 상황에서는 스레드 생성 비용이 그 작업의 계산 시간보다 커진다.
그래서 Fork/Join 프레임워크는 실행 단위를 스레드에서 떼어내고자 ForkJoinTask라는 규약을 고안했다. ForkJoinTask는 추상 클래스로, new IncrementTask(arr, 0, 1000)와 같이 처리할 정보만 담은 가벼운 객체를 만들 수 있게 한다. 이는 스레드와 달리 단순 자바 객체이므로 수만 개를 만들어도 부담이 없다.
하지만 우리가 ForkJoinTask를 직접 상속할 일은 거의 없다. ForkJoinTask는 실행 규약만을 갖는 추상 클래스이고, 실제로는 셋 중 하나를 골라 활용하게 된다.
이름
| 클래스 | 언제 쓰나 |
| RecursiveTask<V> | 결과를 반환할 때 (합계, 최댓값, 정렬 결과) |
| RecursiveAction | 결과 없이 부수 효과만 (제자리 정렬, 이미지 필터) |
| CountedCompleter<T> | join 없이 완료 콜백으로 결과를 전파할 때 |
배열의 모든 원소를 1씩 증가시키는 예제 코드로 살펴보자. 이 경우에는 처리 결과가 필요 없기에 RecursiveAction을 활용하면 되고, 요청을 서브태스크로 분할하고 더 이상 분할할 수 없을 때 개별 서브태스크를 처리하는 compute() 메소드를 구현하면 된다. 나머지, 즉 태스크를 어느 스레드가 언제 실행할지는 ForkJoinPool이 알아서 정한다.
class IncrementTask extends RecursiveAction {
    final long[] array;
    final int lo, hi;

    IncrementTask(long[] array, int lo, int hi) {
        this.array = array;
        this.lo = lo;
        this.hi = hi;
    }

    protected void compute() {
        if (hi - lo < THRESHOLD) {
            for (int i = lo; i < hi; ++i)
                array[i]++;
        }
        else {
            int mid = (lo + hi) >>> 1;
            invokeAll(
                new IncrementTask(array, lo, mid),
                new IncrementTask(array, mid, hi)
            );
        }
    }
}
실제 실행은 별도로 존재하는 소수의 워커 스레드가 담당한다. 이들이 태스크 객체를 주워다 compute()를 호출한다. 즉, 작업의 정의(태스크)와 실행(스레드)이 분리된 구조이다. 이를 통해 블로킹 작업이 없는 순수 계산 태스크라면 작업을 아무리 잘게 쪼개도 스레드 수는 코어 수 그대로 유지할 수 있다.
반대로 말하면, 태스크 안에서 블로킹이 일어나면 이 전제가 깨진다. 워커가 join()이나 ManagedBlocker에서 막히면 ForkJoinPool은 병렬성을 유지하기 위해 보상 스레드(compensation thread) 를 추가로 만든다. parallelism=4인 풀에서 12개 태스크를 블로킹시키고 getPoolSize()를 찍어보면 13이 나온다. 기본 상한은 DEFAULT_COMMON_MAX_SPARES = 256이다.
분할 정복(divide and conquer) 알고리즘
대부분의 compute 메서드 구현은 다음과 같은 의사코드 형식을 유지한다. 그리고 이는 우리에게 익숙한 분할 정복(divide and conquer) 알고리즘의 병렬화 버전이다.
if (태스크 분할이 필요한 경우) {
    태스크를 두 서브태스크로 분할
    태스크가 다시 서브태스크로 분할되도록 이 메서드를 재귀적으로 호출함
    모든 서브태스크의 연산이 완료될 때까지 기다림
    각 서브태스크의 결과를 합침
} else {
    순차적으로 태스크 계산
}
따라서 Fork/Join 프레임워크의 활용에 적합한 문제 역시, 분할할 수 있는 문제라고 말할 수 있다. ForkJoinTask의 javadoc은 이 제약을 다음과 같이 명시한다.
The efficiency of ForkJoinTasks stems from a set of restrictions ... reflecting their main use as computational tasks calculating pure functions or operating on purely isolated objects.
문제가 잘 축소될 가능성이 있는지 판단하는 실용적인 방법 중 하나는, 문제와 그 하위 작업에 다음 체크리스트를 적용하는 것이다.
- 하위 작업들이 명시적인 협력이나 동기화 없이 작동할 수 있는가?
- 하위 작업들이 순수 함수인가? 즉, 데이터 변경 없이 데이터로부터 값을 계산할 수 있는가?
- 하위 작업들에 대한 분할과 정복은 자연스러운가?
여기에 Oracle의 공식 가이드가 덧붙이는 실무 조건이 두 가지 더 있다.
- I/O를 섞지 말 것: "fork/join tasks should operate as 'pure' in-memory algorithms in which no I/O operations come into play"
- 너무 잘게 쪼개지 말 것: 태스크 하나가 "프레임워크의 관리 오버헤드를 상쇄할 만큼"의 계산량은 가져야 한다. THRESHOLD가 존재하는 이유다.
[ 작업 훔치기(Work Stealing) 알고리즘 ]
작업 훔치기 알고리즘의 필요성
우리 컴퓨터에 8개의 코어가 존재하고, ForkJoinPool이 위의 IncrementTask 작업을 내부적으로 8개의 서브태스크로 나누어 처리한다고 하자. 이론적으로는 코어 개수만큼 병렬화된 태스크로 작업 부하를 분할하면 모든 CPU 코어에서 태스크를 실행할 것이고, 크기가 같은 각각의 태스크는 같은 시간에 종료될 것이라 생각할 수 있다.
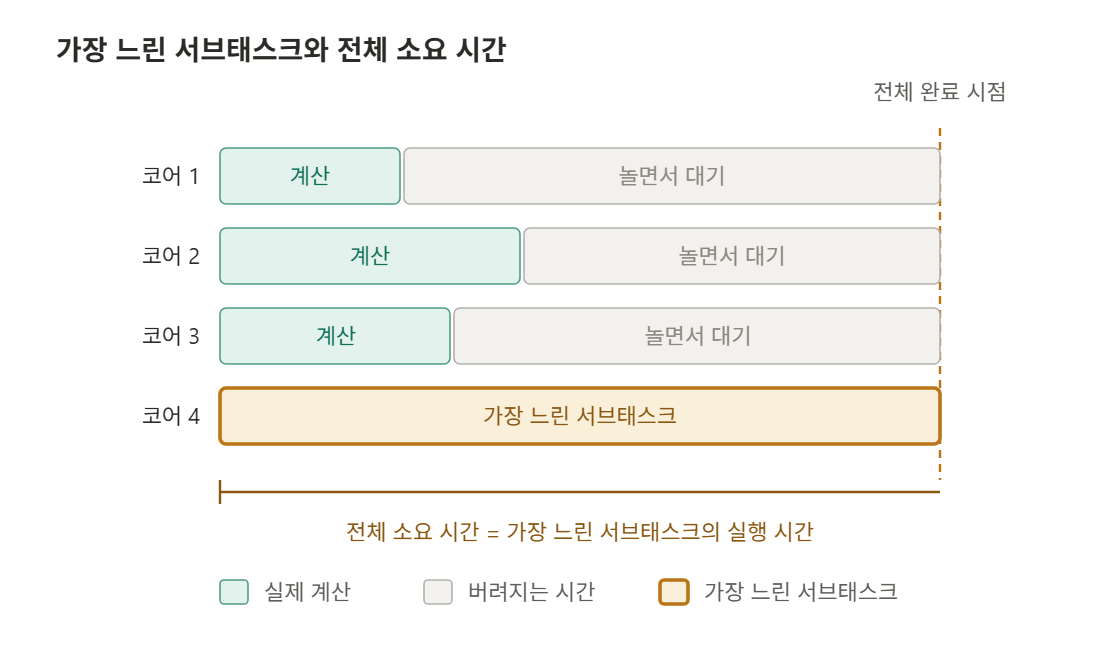
하지만 훨씬 복잡한 시나리오를 다루는 현실에서는 각각의 서브태스크의 작업완료 시간이 크게 달라질 수 있다. 분할 기법이 비효율적이었을 수도 있고, 아니면 예기치 않게 디스크 접근 속도가 저하되었거나 외부 서비스와 협력하는 과정에서 지연이 생길 수 있기 때문이다. 실제로 하나의 서브태스크가 다른 서브태스크에 비해 10배 걸리는 일은 흔하다.
문제는 빨리 끝난 코어들이 놀면서 가장 느린 서브태스크를 기다리는 것이다. 그리고 전체 소요 시간은 가장 느린 서브태스크에 의해 결정된다. 작업을 나누어 처리하지만, 어느 조각이 오래 걸릴지 알 수 없다는 근본 한계가 있는 것이다. Fork/Join 프레임워크는 이러한 문제를 해결하고자 작업 훔치기(Work Stealing) 알고리즘을 구현한다.
작업 훔치기 알고리즘의 구현
작업 훔치기(work-stealing)의 발상은 단순하다. 일이 떨어진 스레드가 남의 일감을 가져가게 하여, 실시간으로 부하를 분배하는 것이다. 이를 위해 양쪽 끝에서 작업을 넣고 뺄 수 있는 작업 큐(WorkQueue) 가 필요한데, 덱(deque, double-ended queue) 자료구조를 내부적으로 구현하여 사용한다. 참고로 이는 ForkJoinPool의 내부 클래스일 뿐, 자바 표준 컬렉션 java.util.Deque가 아니다.
base, top 두 인덱스가 작업 큐의 전부다. base는 도둑이, top은 주인이 쓴다.
// JDK 25 기준
static final class WorkQueue {
    final ForkJoinWorkerThread owner;  // 큐의 주인, 외부 제출 큐면 null
    ForkJoinTask<?>[] array;           // 태스크를 담는 배열 (2의 거듭제곱 크기 순환 버퍼)
    int base;                          // 도둑이 훔쳐갈 위치 (poll)
    int top;                           // 주인이 넣고 빼는 위치 (push/pop)
    ...
}
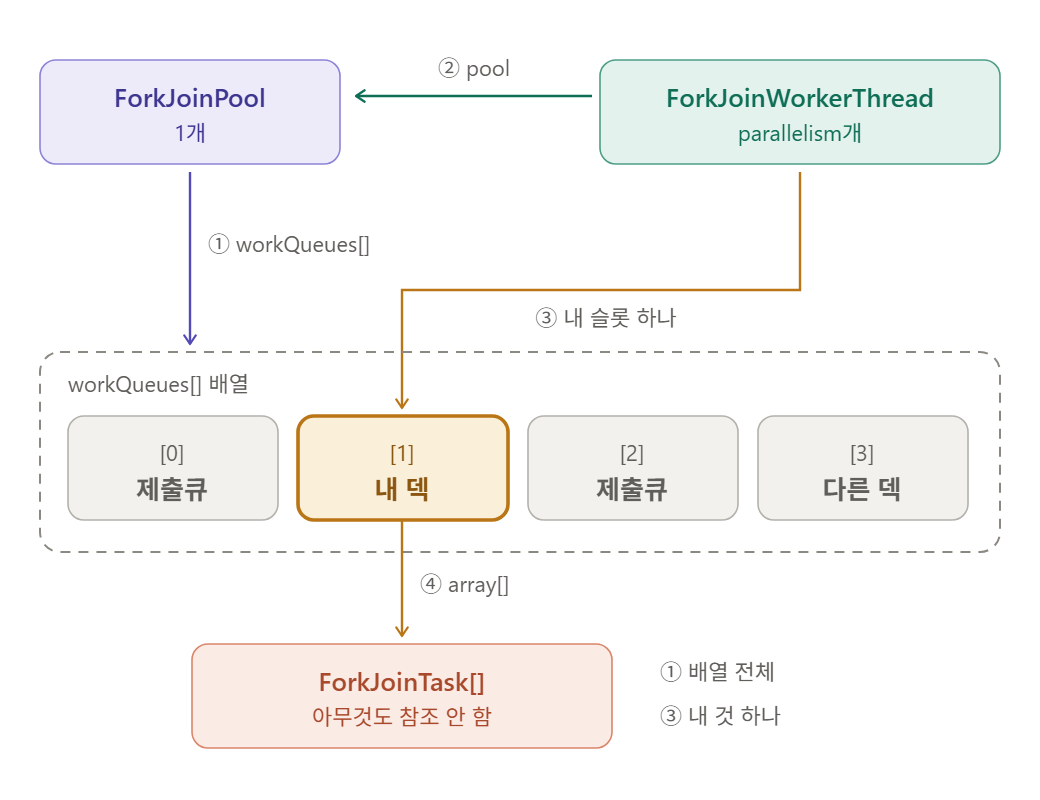
모든 작업 큐는 배열의 형태로 ForkJoinPool 내부에서 관리된다. 실제로 작업을 처리하는 워커 스레드(ForkJoinWorkerThread)는 자신이 기본적으로 처리하는 WorkQueue에 대한 참조를 갖는다. 만약 필요하다면 남의 큐에 접근할 수 있도록 ForkJoinPool에 대한 참조도 존재한다.
class ForkJoinPool {
    WorkQueue[] queues;                     // ①  전체 작업 큐
}

class ForkJoinWorkerThread {
    final ForkJoinPool pool;                // ②
    final ForkJoinPool.WorkQueue workQueue; // ③  ← 자기 것
}

class WorkQueue {
    final ForkJoinWorkerThread owner;       // ④  ← 주인으로 되돌아가는 링크
    ForkJoinTask<?>[] array;                // ⑤
}

class ForkJoinTask {
    volatile int status;   // 풀이나 큐를 가리키는 참조는 없다
    volatile Aux aux;      // 완료를 기다리는 스레드 목록, 또는 던져진 예외
}
이를 도식화된 구조로 살펴보면 다음과 같다.
최초 제출부터 훔치기까지의 과정
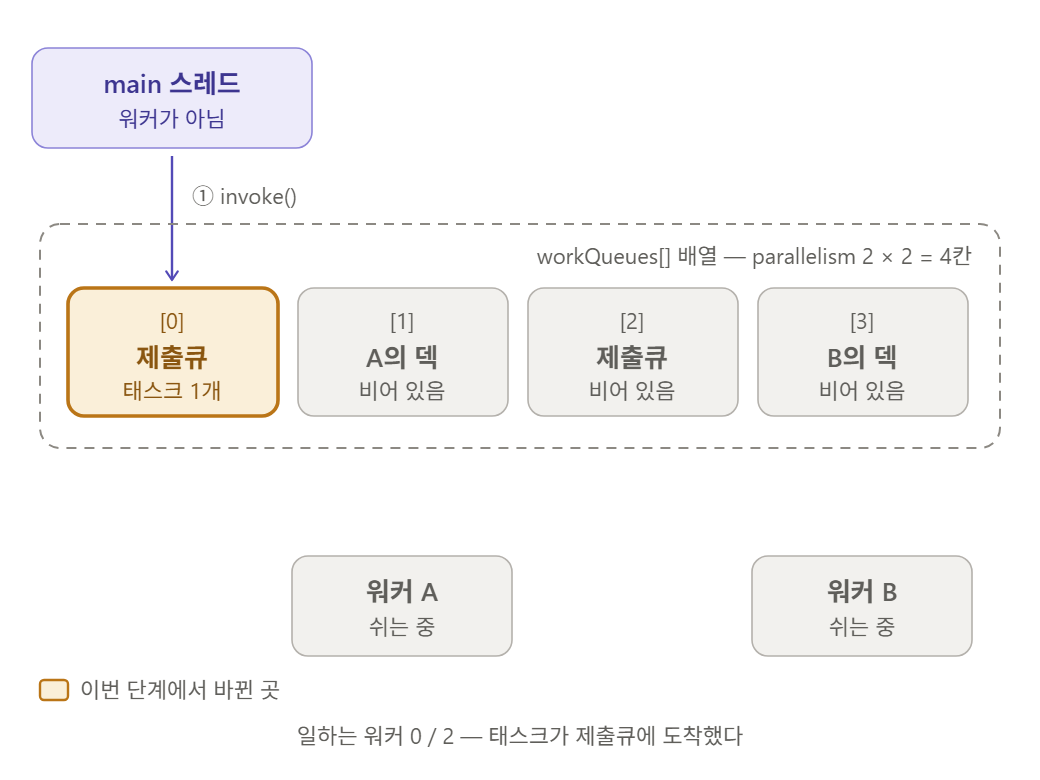
먼저 최초에 외부 스레드가 작업을 제출하면, 제출큐에 첫 번째 태스크가 적재된다.
이후에 임의의 워커 스레드가 제출큐의 작업을 가져간다. 여기서 한 가지 짚을 것은, 가져온 태스크를 자기 덱에 넣는 게 아니라 곧바로 실행한다는 점이다. 덱에 쌓이는 것은 그 태스크가 fork()로 만들어낸 자식들이다.
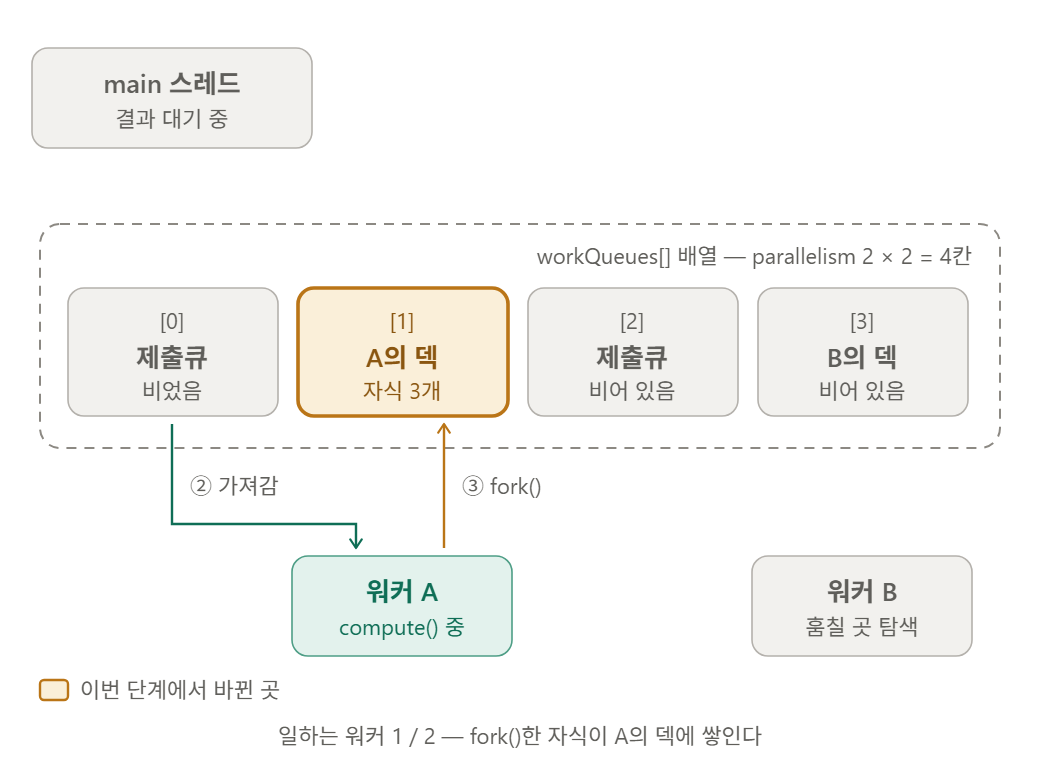
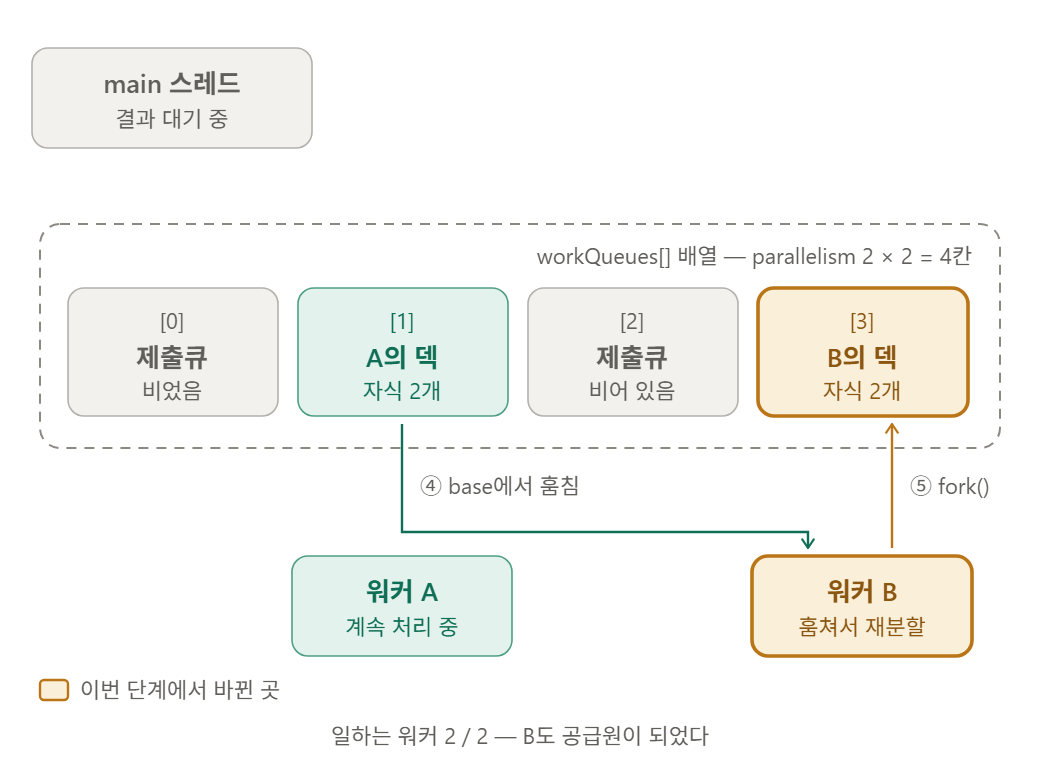
그리고 다른 유휴 상태의 워커가 이제 작업을 A의 덱 base로부터 가져와서 자기 자신에게 할당하고 처리한다. 앞에서 본 대로, base에 있는 것은 가장 오래된, 곧 가장 큰 태스크이므로, B는 이것을 다시 쪼개면서 새로운 공급원이 된다.
[ 작업 훔치기 알고리즘의 구현 상세 ]
왜 덱의 양 끝을 다르게 쓰는가
양방향 큐를 쓴다고만 하면 절반만 설명한 것이다. 핵심은 주인과 도둑이 서로 반대편 끝을 쓴다는 비대칭에 있다.
- 주인은 top에서 LIFO(youngest-first) 로 pop 한다
- 도둑은 base에서 FIFO(oldest-first) 로 steal 한다
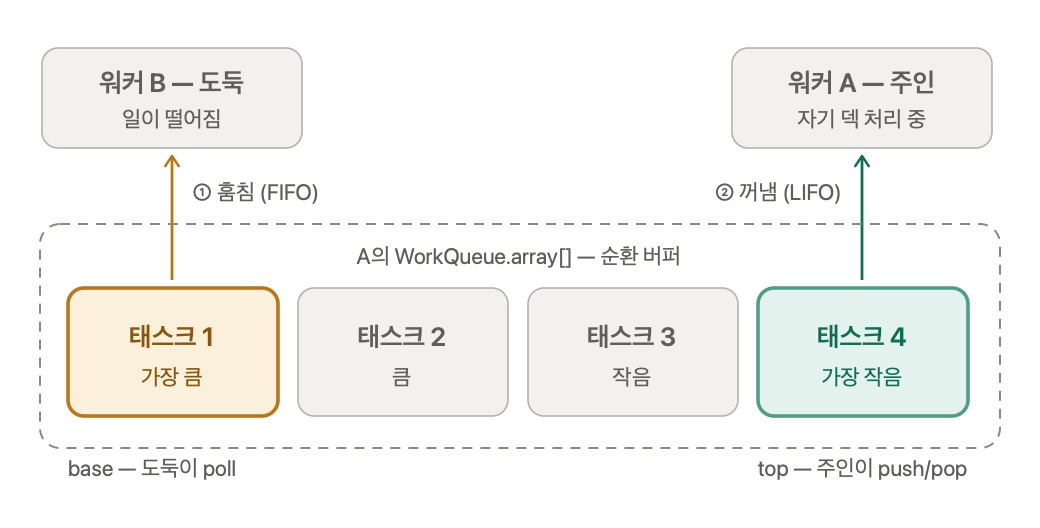
top과 base를 구분하여 쓰는 이유는 다음의 장점들이 있기 때문이다.
- 경합 감소: 주인은 배열의 오른쪽 끝, 도둑은 왼쪽 끝에 접근하여, 큐에 태스크가 어느 정도 쌓여 있는 한 둘은 물리적으로 부딪히지 않음
- 큰 덩어리 훔치기 가능: 분할정복은 큰 태스크를 먼저 만들어 쪼개므로, 가장 오래된 태스크가 가장 큼. 여유로운 도둑이 base에서 큰 작업을 가져가면, 이를 다시 분해하면서 새로운 공급원이 될 수 있음. 훔치기 자체가 비싼 연산이므로, 훔치는 횟수를 줄이는 것이 중요함
- 캐시 지역성: 주인이 방금 fork한 태스크를 바로 다시 꺼내므로, 그 태스크가 참조하는 데이터가 캐시에 살아있을 확률이 높음
작업큐 배열의 크기와 인덱스 구분
ForkJoinPool에서 할당되는 queues[] 배열의 크기는 병렬성(parallelism, 동시에 계산을 진행시키려는 목표 스레드 수)의 약 2배다. 정확히는 병렬성을 2의 거듭제곱으로 올림한 값의 두 배이고, 여기에 MIN_QUEUES_SIZE = 16이라는 하한이 걸린다. 그래서 병렬성이 8 이하면 배열은 언제나 16칸이다. 왜 이렇게 넉넉히 잡는지 이해하려면 먼저 ForkJoinPool에 작업이 제출되는 방식을 볼 필요가 있다.
ForkJoinPool에 제출되는 작업은 대개 compute 메서드 내부에서 작은 작업으로 세분화되면서 만들어지고, 워커 스레드를 통해 처리된다. 하지만 작업이 최초 제출되는 경우에는 메인 스레드가 이 역할을 맡는다. 메인 스레드는 워커 스레드가 아니라서 자기 덱이 없는데, ForkJoinPool 어딘가에는 태스크를 제출해야 한다.
public static void main(String[] args) {
    ForkJoinPool.commonPool().invoke(new IncrementTask(arr, 0, 1000));
    //          ↑ main 스레드. 워커가 아님
}
따라서 ForkJoinPool은 작업을 2가지로 구분하여 다루어야 한다.
- 외부 스레드가 제출한 작업: 외부 스레드가 작업을 제출하면, 유휴 상태의 워커가 이를 가로채고 요청을 처리함
- 워커 스레드가 처리하는 작업: 워커는 자기가 처리하는 작업들을 관리하고, 필요 시 다른 워커가 접근하여 작업 훔치기를 할 수 있도록 함
따라서 ForkJoinPool은 WorkQueue 배열을 인덱스 기준으로 두 종류로 나누어 사용한다.
- 짝수 인덱스: 외부 스레드의 제출큐 (shared queue)
- 홀수 인덱스: 워커의 작업큐의 덱 (worker queue)
실제로 parallelism=8인 풀에 외부 스레드 8개가 작업을 제출한 뒤 배열을 들여다보면 정확히 이 규칙대로 채워진다.
parallelism=8, queues.length=16

[ 0] 제출큐(shared)    [ 1] 워커덱 owner=ForkJoinPool-1-worker-6
[ 2] 제출큐(shared)    [ 3] 워커덱 owner=ForkJoinPool-1-worker-3
[ 4] 제출큐(shared)    [ 5] 워커덱 owner=ForkJoinPool-1-worker-1
[ 6] 제출큐(shared)    [ 7] 워커덱 owner=ForkJoinPool-1-worker-4
[ 8] 제출큐(shared)    [ 9] 워커덱 owner=ForkJoinPool-1-worker-5
[10] 제출큐(shared)    [11] 워커덱 owner=ForkJoinPool-1-worker-7
[12] 제출큐(shared)    [13] 워커덱 owner=ForkJoinPool-1-worker-8
[14] 제출큐(shared)    [15] 워커덱 owner=ForkJoinPool-1-worker-2
인덱스를 짝/홀로 나누어 사용하는 방식은 다음과 같은 부가적인 이점이 있다.
- 스캔 로직의 간소화: 워커가 일감을 찾을 때는 배열을 무작위 시작점부터 훑는데, 둘을 별도 배열로 분리했다면 "제출큐 배열을 먼저 보고, 없으면 작업큐 배열을 보고" 하는 이중 로직이 필요해짐
- 작업 구분의 간소화: 짝/홀 인덱스 여부만으로 작업 종류를 구분할 수 있음
- 배열 확장의 용이함: 작업큐 배열은 워커가 늘어나면 두 배로 확장되는데, 구간으로 나누지 않았으므로 경계값을 다시 계산하거나 큐를 옮길 일이 없음. 워커 큐는 홀수 인덱스를 그대로 유지함
그런데 왜 제출큐도 이만큼이나 필요한가?
작업을 제출하는 스레드의 수는 워커의 수와 무관하다. 스프링 애플리케이션과 같이 멀티 스레드 기반으로 요청을 처리하는 경우에는 작업을 동시 제출하는 스레드가 200개를 넘을 수도 있다. 그런데도 슬롯이 이 정도면 충분한 이유는, 애초에 충돌을 없애려는 설계가 아니기 때문이다.
ForkJoinPool은 제출 스레드를 슬롯에 해싱해서 배치한다. 해시 값으로는 ThreadLocalRandom의 probe를 쓰고, 충돌하면 probe를 재배치해서 다른 슬롯으로 옮겨간다. 즉 이 설계의 전제는 "동시 제출자가 슬롯 수보다 적다"가 아니라, "충돌은 나겠지만 싸고 빠르게 우회할 수 있다" 이다. 따라서 슬롯 하나를 두고 다투지 않는다. 큐가 잠겨 있으면 풀리기를 기다리는 대신 probe를 굴려 곧바로 다른 슬롯으로 옮겨간다.
여기에 두 가지 실용적인 사실이 더해진다.
- 제출큐는 배열에 슬롯만 잡혀 있고, 실제 WorkQueue 객체는 필요할 때 만들어진다(lazy). 200개 스레드가 몰려도 슬롯 수만큼만 만들어진다.
- 제출은 push 한 번으로 끝나는 짧은 연산이다. 실제 계산 시간은 워커 쪽에서 소비되므로, 제출 슬롯이 병목이 되는 구간은 매우 짧다.
[ 실무에서 알아두면 좋은 것들 ]
parallel stream을 위한 commonPool
ForkJoinPool.commonPool()은 애플리케이션 전체가 공유하는 정적 풀이고, parallel stream이 바로 이 풀을 쓴다. 병렬성은 다음과 같이 결정된다. 즉 8코어 머신이면 워커는 7개다(제출 스레드가 하나 거들 것을 감안한 값이다).
pc = Math.max(1, Runtime.getRuntime().availableProcessors() - 1);
이로 인해 parallel stream 안에서 I/O 처리 같은 블로킹 작업이 있으면, 한 곳의 블로킹이 전역에 퍼진다. commonPool 워커가 묶이고, 관계없는 다른 parallel stream이 함께 느려지는 것이다. 격리가 필요하면 전용 ForkJoinPool을 만들어 그 안에서 submit()하도록 하자. 만약 튜닝이 필요하다면, java.util.concurrent.ForkJoinPool.common.parallelism 시스템 프로퍼티를 설정해주어야 한다. 참고로 해당 값을 0으로 설정하면, 워커 스레드를 아예 만들지 않고 제출한 스레드가 직접 실행하는 caller-runs 모드가 된다(getParallelism()은 여전히 1을 보고한다).
블로킹이 불가피하다면 ManagedBlocker
앞서 "I/O를 섞지 말라"고 했지만 현실에서 피할 수 없다면, 최소한 풀에게 알려줘야 한다. ForkJoinPool.ManagedBlocker로 감싸면 풀이 블로킹을 인지하고 보상 스레드를 만들어 병렬성을 유지할 수 있다.
asyncMode, 그리고 가상 스레드
생성자의 asyncMode 플래그를 켜면 주인도 자기 덱을 FIFO로 처리한다. 조인하지 않는 이벤트성 태스크에 적합한 모드다. 그리고 이 모드에는 오늘날 가장 중요한 사용처가 하나 있다. Java 21 가상 스레드의 기본 스케줄러가 바로 asyncMode ForkJoinPool이다.
// java.lang.VirtualThread#createDefaultScheduler
boolean asyncMode = true; // FIFO
return new ForkJoinPool(parallelism, factory, handler, asyncMode, ...);
가상 스레드의 컨티뉴에이션이 곧 이 풀에 제출되는 태스크다. 즉 Fork/Join은 "옛날에 나온 병렬 계산용 도구"가 아니라, 지금 가상 스레드의 기반이 되었다.
참고 자료
- Doug Lea, "A Java Fork/Join Framework", ACM Java Grande 2000 — https://gee.cs.oswego.edu/dl/papers/fj.pdf
- OpenJDK ForkJoinPool.java 설계 주석 (JDK 8 / 17 / 21 / 25) — 짝·홀 인덱스, 제출큐 해싱, LIFO/FIFO 규칙
- OpenJDK ForkJoinPool.java (JDK 7) — 단일 제출큐 시절의 초기 구현
- ForkJoinPool / ForkJoinTask / RecursiveAction javadoc
- java.lang.VirtualThread#createDefaultScheduler (JDK 21+)
- Blumofe & Leiserson, "Scheduling Multithreaded Computations by Work Stealing", JACM 1999 — 작업 훔치기의 이론적 최적성
- Oracle, "Fork and Join: Java Can Excel at Painless Parallel Programming Too!" — https://www.oracle.com/technical-resources/articles/java/fork-join.html
- Herb Sutter, "The Free Lunch Is Over", Dr. Dobb's Journal, 2005 — 클럭 한계와 멀티코어 전환
'Java & Kotlin' 카테고리의 다른 글
| [Java] String.format의 성능 문제와 개선 사항들 (3) | 2026.10.06 |
|---|---|
| [Java] 에러 스택 트레이스 최적화를 도와주는 -XX:+OmitStackTraceInFastThrow(사라진 예외 스택 트레이스) (0) | 2026.08.04 |
| [JVM] 클래스 패스 섀도잉(Classpath Shadowing)이란? (1) | 2026.06.30 |
| [Spring] MySQL의 wait_timeout 설정과 HikariCP 6.1.0에 추가된 maxLifeTime 분산 기능 (250) | 2026.02.03 |
| [Java] synchronized의 한계를 극복하기 위한 Lock 인터페이스와 ReentrantLock 클래스 (2) | 2026.01.13 |